先把定义说清楚:Local API 浏览器,指的是那种在你本机跑一个后台 HTTP 服务的指纹浏览器客户端。客户端启动后会在本地地址(通常是 127.0.0.1 加一个固定端口)上监听请求,你的脚本往这个地址发 HTTP 请求,就能查询环境列表、启动指定环境、关闭环境。它不是云端接口,请求不出本机,所以叫 Local。
很多人第一次接触时会误以为这是另一套浏览器。不是。它就是你平时点鼠标用的那个客户端,只是多开了一个口子让程序来点。
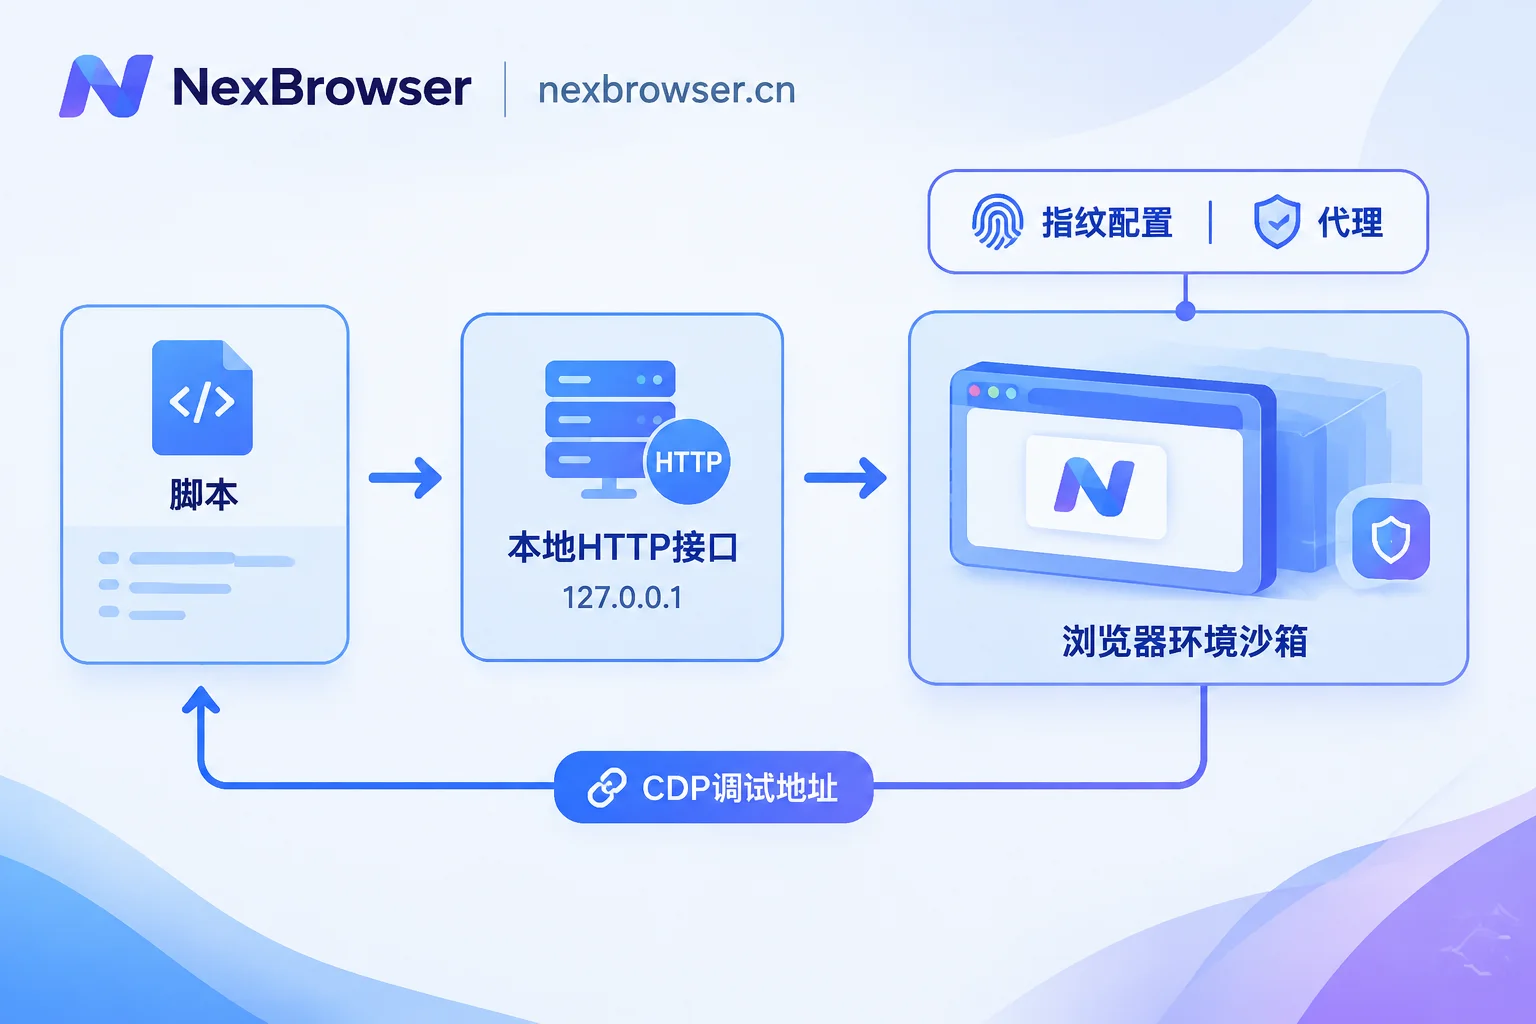
调用链路长什么样
理解这条链路,后面所有报错都能归位:
- 脚本向本地接口发请求,带上环境 ID 和启动参数,要求启动某个环境;
- 客户端收到后,拉起一个加载了该环境指纹配置与代理的独立浏览器沙箱;
- 接口在响应里返回这个沙箱的 CDP(Chrome DevTools Protocol)WebSocket 调试地址,形如
ws://127.0.0.1:xxxxx/devtools/browser/...,有的还会一并返回 WebDriver 驱动路径; - 脚本拿这个地址,用 Puppeteer 的
connect、Playwright 的connectOverCDP,或者把调试端口填进 Selenium 的debuggerAddress,接管这个已经开好的浏览器; - 跑完任务,再调一次关闭接口收尾。
关键点在第 3 步和第 4 步之间:自动化框架不负责启动浏览器,它只是连上一个已经存在的浏览器。这和平时用 Selenium 自己拉 chromedriver 的写法不一样,也是新手最容易写错的地方——如果你还在让框架自己 launch,那指纹配置和代理绑定全都不会生效,等于开了个裸浏览器。
动手前先确认三件事
跳过这三步直接写代码,八成会卡在连接失败上,而且你会误以为是代码问题。
第一,客户端必须在本机运行着。 Local API 的服务是客户端进程提供的,客户端关了,接口就没了。Windows 下常见的坑是点了窗口右上角的叉号,以为退出了,其实进程还在托盘;反过来也有人用任务管理器结束了进程,然后纳闷接口为什么突然 503。跑批量任务前,先确认托盘图标还在。
第二,这个环境用鼠标能正常打开。 手动双击打开环境,看能不能正常加载页面、能不能访问目标站点。如果手动都打不开,API 启动它也一样打不开,只是报错信息更难读。把变量先降到一个。
第三,代理已经验证过出口。 环境绑的代理如果失效,API 可能照样返回“启动成功”,因为浏览器进程确实起来了,只是页面加载不出来。脚本这时会卡在 goto 超时上,报错指向网络层,你却会去查 API。建议在环境配置里先做一次代理检测,确认出口 IP 和地区符合预期,再让脚本接管。绑代理和验出口的完整做法,可以看代理IP配置这篇。
第一次跑通,按这个顺序
不要一上来就写完整业务脚本。按下面顺序走,每一步都能独立确认对错:
第一步,用浏览器地址栏或 curl 请求一下“查询环境列表”接口。 这是最轻的一个请求,能返回 JSON 就说明本地服务活着、端口对了、没被拦。这一步通了,后面出问题就不是环境配置的事了。
第二步,调启动接口,只传一个环境 ID。 看两件事:屏幕上有没有真的弹出一个浏览器窗口;响应 JSON 里有没有拿到 WebSocket 地址或调试端口。窗口弹出了但没拿到地址,说明你读错了返回字段的层级;地址拿到了窗口没弹,检查是不是传了无头参数。
第三步,才让框架连上去,只做一件事——打开一个能查 IP 的页面,截图。 这一步同时验证了三件事:CDP 连接成功、代理生效、页面能渲染。截图里的出口 IP 和你在环境里配的对得上,这条链路就算打通了。
第四步,加关闭接口。 很多人的脚本跑完不关环境,几十个窗口堆在那儿吃内存,机器越跑越慢,后面就开始出各种玄学超时。关闭接口要写在异常处理里,保证报错时也能收尾。
跑通之后再往里填业务逻辑,出问题时你至少知道是新加的部分坏了。
国内网络下最常卡住的几处
系统代理把本地请求也拦了。 这是国内环境下第一高频问题。很多加速工具会设置全局系统代理,而 Python 的 requests、Node 的部分 HTTP 库会读取 HTTP_PROXY / HTTPS_PROXY 环境变量,结果你发给 127.0.0.1 的请求被转到代理服务器上绕了一圈,然后超时或者返回 502。解决办法是把 127.0.0.1,localhost 加进 NO_PROXY 环境变量,或者在代码里显式设置 proxies={"http": None, "https": None}。注意这和环境里绑的代理是两回事——环境代理是浏览器出网用的,系统代理是你的脚本发请求用的,两者混在一起才最容易误判。
localhost 解析到了 IPv6。 有些系统下 localhost 会先解析成 ::1,而本地服务只监听了 IPv4 的 127.0.0.1,于是连接被拒。遇到 ECONNREFUSED 且确认服务在跑,先把地址里的 localhost 换成 127.0.0.1 试一次,这一改能解决不少看起来很邪门的问题。
端口被别的程序占了。 本地接口用的端口如果和你机器上其他开发工具、代理软件撞上,客户端的服务可能起不来,或者起来了但你连到了别的程序上(返回内容完全不是 JSON 就是这种情况)。Windows 下用 netstat -ano | findstr 端口号 看谁占着,再去任务管理器按 PID 对人。能改端口就改,改不了就把冲突的程序挪走。
杀毒软件和防火墙拦了本地监听。 国内不少机器装着安全软件,对“某程序正在监听端口”这类行为会静默拦截,不弹窗。表现是客户端看起来一切正常,接口就是连不上。把客户端加进信任列表,或者临时退出安全软件复测一次,能很快分辨是不是这个原因。
并发开太多,机器扛不住。 接口调用本身很快,但每启动一个环境就是一个完整的浏览器进程。十几个窗口同时跑,内存和 CPU 先到顶,后果是页面加载超时、CDP 连接中途断开,报错五花八门却都不指向真正的原因。先从三五个并发开始,观察内存占用再往上加。
什么时候其实不需要写代码
一个容易被忽略的判断:如果你要做的只是每天在几十个环境里重复同一套固定动作——打开某页、填表、点提交,那用客户端自带的无代码 RPA 流程往往更划算,不用维护脚本,不用处理上面那堆本地网络问题。
Local API 真正的价值在于它能接进你自己的系统:数据来自你的数据库、任务要和内部流程联动、结果要写回自家后台,或者要按业务逻辑动态决定跑哪些环境。这些场景下脚本不可替代。反过来,为了跑一个固定流程而搭一套脚本工程,维护成本会比你预计的高。
这个取舍在AI浏览器自动化这篇里按 MCP、RPA、Local API 三条路径分别拆过,选型前值得先看一眼。
权限这件事,各家规则不一样
需要提醒的是,Local API 在不同产品里的开放规则差别很大。部分指纹浏览器把它划为付费套餐专属,免费用户看不到入口;有的虽然开放,但对调用频率或并发数设了上限,跑量上去就会被限流。选型时这一条最好提前确认,别等脚本写完才发现要升级套餐。
NexBrowser 的规则是功能不分档:免费档开放全部功能,Local API 免费且不限调用次数,付费只增加窗口数量和团队成员容量。也就是说你可以先用免费额度把上面整条链路完整跑通,确认接口能用、并发够用,再根据实际窗口需求决定要不要扩容。具体额度以免费额度页当次说明为准。
至于本机这一端,Local API 依赖客户端在本地运行,所以第一步还是得先把客户端装上——下载页有国内和海外两条线路,国内直接走国内线路更稳,安装包带代码签名,安装前留意一下签名信息。目前提供 Windows 客户端,macOS 版本还在开发中。装完先把一个环境手动建起来、代理验通,再回来接接口,顺序别倒过来。
最后一句关于边界:自动化只用于你自有账号的日常运维,批量注册、模拟真人养号、绕过平台验证这类操作不在讨论范围内,也不是靠工具能规避风险的事。接口能帮你省掉重复点击,但省不掉平台规则。


评论(0)