先说结论:浏览器 RPA 按照写好的步骤执行操作;浏览器 MCP 是一条通道,让大模型读取页面后自己决定怎么操作。
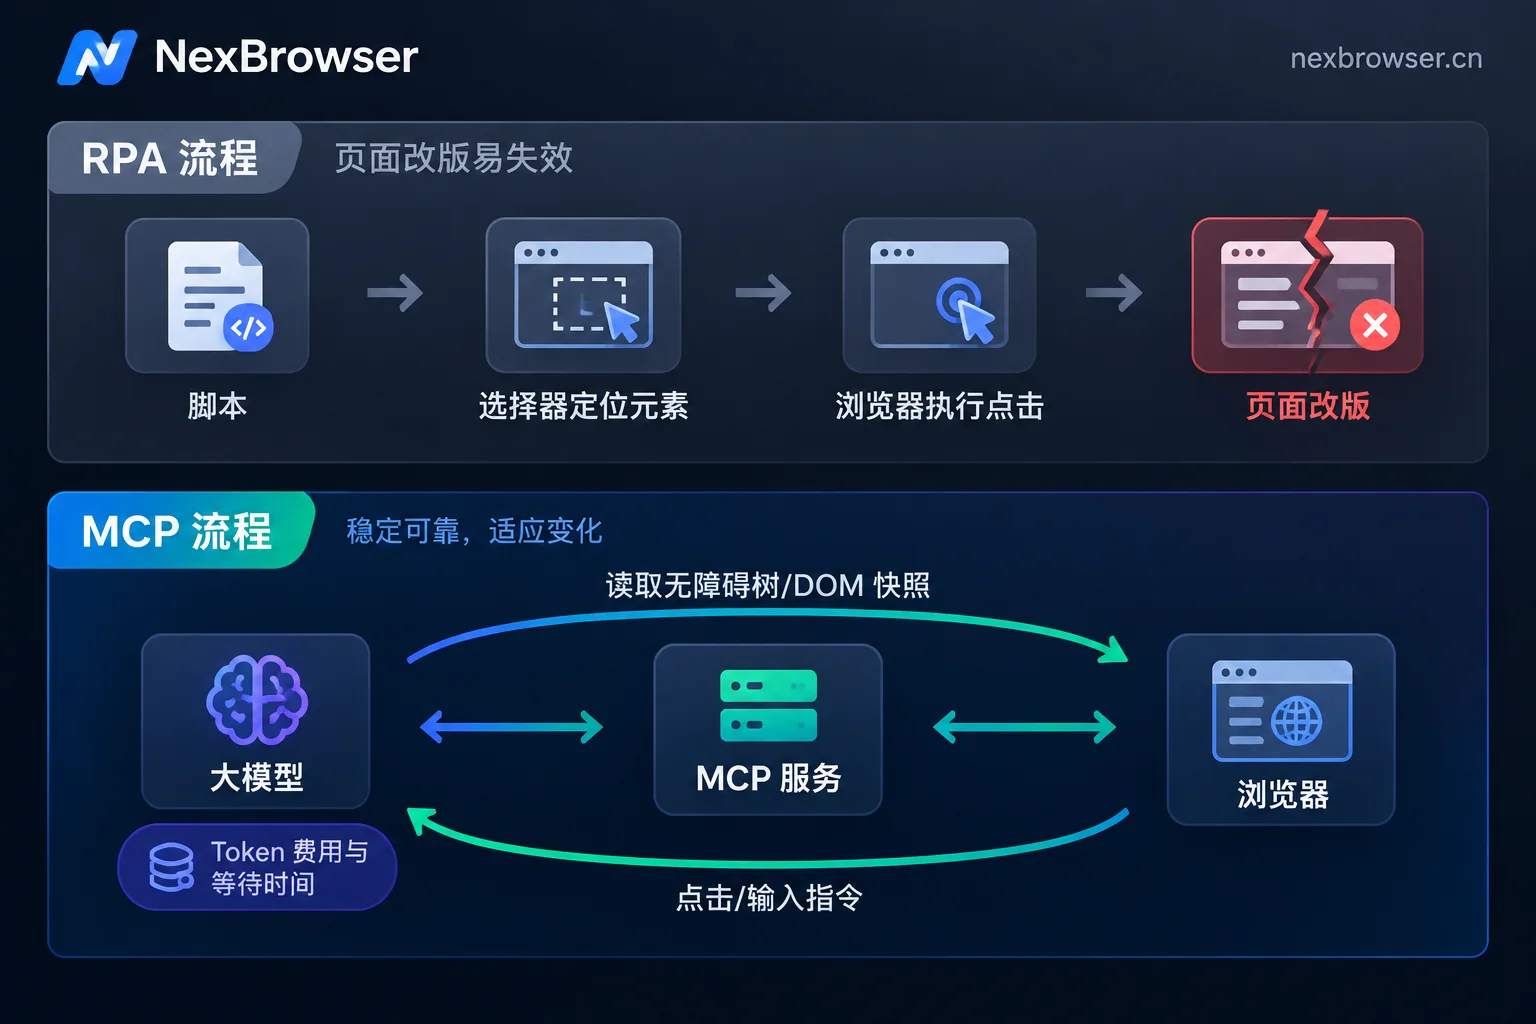
RPA 速度快、成本低,同样的输入会走同样的步骤,但网页一改版就容易中断。MCP 配合大模型时能应对页面变化和比较模糊的目标,代价是每一步都要调用模型,会产生 Token 费用和等待时间,偶尔还会做出你没有预料到的操作。
两者并不互相替代。比较常见的做法是:固定流程交给 RPA,需要理解页面或临场判断的环节交给 AI。
两者分别是什么
RPA:按脚本执行的流程机器人
RPA(机器人流程自动化)会模拟人的鼠标和键盘操作,按照预先配置好的流程逐步执行。在网页上,它通常依靠以下方式定位元素:
- XPath 或 CSS 选择器
- 页面上的图像或坐标位置
- 开发者写好的 if/else 判断逻辑
它不会自己推理。你没告诉它的情况,它一般处理不了,遇到异常就会报错停下。
浏览器 MCP:大模型和浏览器之间的标准接口
MCP(Model Context Protocol)是 Anthropic 在 2024 年 11 月开源的协议,基于 JSON-RPC,规定 AI 应用如何用统一的方式调用外部工具和数据。
浏览器 MCP 指这套协议在浏览器工具上的具体实现,例如 Playwright MCP 和 Chrome DevTools MCP。它本身不包含任何预设流程,只是把浏览器的各项能力包装成工具交给 AI Agent 调用,例如:
- 读取页面结构(无障碍树、DOM 快照)
- 点击和输入
- 监听网络请求
容易误解的一点是:MCP 不是一个会自己干活的机器人。真正做决策的是接在另一端的大模型,MCP 负责把页面信息传给模型,再把模型的指令传回浏览器执行。
用同一个任务看差别
假设任务是:每天登录自己的店铺后台,导出前一天的订单。
用 RPA 来做: 把“打开后台 → 点订单 → 选日期 → 点导出”这几步配置好,之后每天按同样的步骤跑,几秒钟就能完成。但如果某天后台把“导出”按钮挪进了下拉菜单,原来的选择器找不到这个元素,流程就会报错停下,需要人去修改脚本。
用浏览器 MCP + 大模型来做: 你只需告诉 Agent“导出昨天的订单”。它读取页面的语义结构,找到名称里含“导出”的按钮。即使按钮换了位置,它通常也能根据语义重新找到。代价是每一步都要把页面信息发给模型,再等模型返回结果。店铺一多,Token 费用就会明显增加,速度也比 RPA 慢。模型还可能理解偏差,比如把“导出昨天”点成“导出全部”。
核心差异对照
| 对比项 | 浏览器 RPA | 浏览器 MCP + 大模型 |
|---|---|---|
| 由什么驱动 | 预设规则、选择器、坐标 | 模型根据页面信息推理 |
| 网页改版后 | 容易中断,需要改脚本 | 多数情况能根据语义自行适应 |
| 执行速度 | 快,在本地直接执行 | 每一步都要等模型返回 |
| 运行成本 | 不消耗模型 Token | 按模型调用量付费 |
| 结果是否可预期 | 同样的输入走同样的步骤 | 受模型影响,可能出现非预期操作 |
| 适合的任务量 | 高频、大批量 | 低频、需要判断的任务 |
怎么选
优先用 RPA 的情况:
- 步骤固定、格式标准,每次操作几乎一样
- 出错代价高,不能接受“偶尔点错”
- 任务量大、频率高,按调用付费的方式成本太高
典型例子:定时导出报表、按表格批量录入商品信息、提交固定格式的表单。
考虑用浏览器 MCP 的情况:
- 只能说清目标,说不清具体步骤
- 需要读懂页面上的非结构化内容,比如商品描述或评论
- 页面经常变化,或者是第一次接触、不熟悉的页面
典型例子:浏览几个竞品页面并汇总价格和卖点、在不同站点之间搜索比对信息。
两者组合使用: 流程主体用 RPA 保证速度和成本,在遇到意外弹窗或页面改版等异常时,再交给 AI Agent 判断处理,处理完回到原流程。
一个简单的判断方法:如果你能把步骤一条条写清楚,而且页面近期不太会变,先用 RPA;如果只能描述想要的结果,再考虑交给模型处理。
在多账号浏览器里运行自动化前,先确认这几件事
无论用哪种方式,自动化都只是在某个浏览器环境里操作页面。如果环境没有隔离好、代理没有绑对,自动化只会把问题放大。
- 先手动把环境准备好。 确认环境之间互相隔离,代理出口也符合预期。具体检查方法可参考新建环境后怎么确认隔离生效和给每个环境绑定代理并验证出口。
- 一个任务对应一个环境。 运行前确认当前操作的是哪个账号,避免把 A 店铺的操作做到 B 店铺上。
- 重要操作保留人工确认。 用 MCP 让模型直接操作已登录账号时,提交、付款、删除、改价这类无法撤回的步骤,建议保留人工确认,或者先在测试环境中试跑。
- 只用于自己名下账号的日常运营。 不要用自动化批量注册账号或规避平台审核。各平台对自动化操作有各自的规则,请以平台的规定为准。
在 NexBrowser 里怎么开始
NexBrowser 客户端内置无代码 RPA 和 AI Agent。免费档开放全部功能,Local API 免费且不限调用次数,付费只会增加窗口数和成员数。
- 步骤固定的任务:可以直接在客户端的 RPA 中搭建流程。
- 想让外部 Agent 通过 MCP 接入:需要先启动环境,再连接到对应窗口,具体操作见MCP 怎么连接指纹浏览器。官方目前没有公开专门的 MCP 配置说明,接入细节以官网为准。
客户端目前支持 Windows,macOS 版本还在开发中。下载页提供国内和海外两条线路,安装包带有代码签名,建议安装前先核对签名。准备好后可以到下载页安装,先建好第一个环境,再决定交给 RPA 还是 Agent 来操作。


评论(0)