先说结论:会被识别。用大模型决定「下一步点哪里」,浏览器那一侧并不会因此隐身。负责执行的仍然是自动化驱动,它会在协议、环境指纹、网络出口和操作轨迹上留下痕迹。现在主流的风控系统会把这些信号合在一起打分,AI Agent 不享受豁免。
下面先说平台看哪些信号,再说做多账号运营的人能控制什么、不该指望什么。
平台看的是综合分,不是某一个开关
Cloudflare、DataDome、Akamai、HUMAN Security 这类反自动化服务(Bot Management)一般不靠单一特征下结论。它们把浏览器指纹、IP 信誉、行为轨迹和验证码的作答结果放在一起,算出一个风险分。
所以单独一项不完美,不一定马上被拦。几项小问题加起来超过阈值,才会出现弹验证码、静默限流、要求二次验证之类的处置。亚马逊、Shopee、eBay 和各家社媒平台的具体阈值和处置规则都不公开,所以「改了某个设置就一定安全」这类说法没有依据。
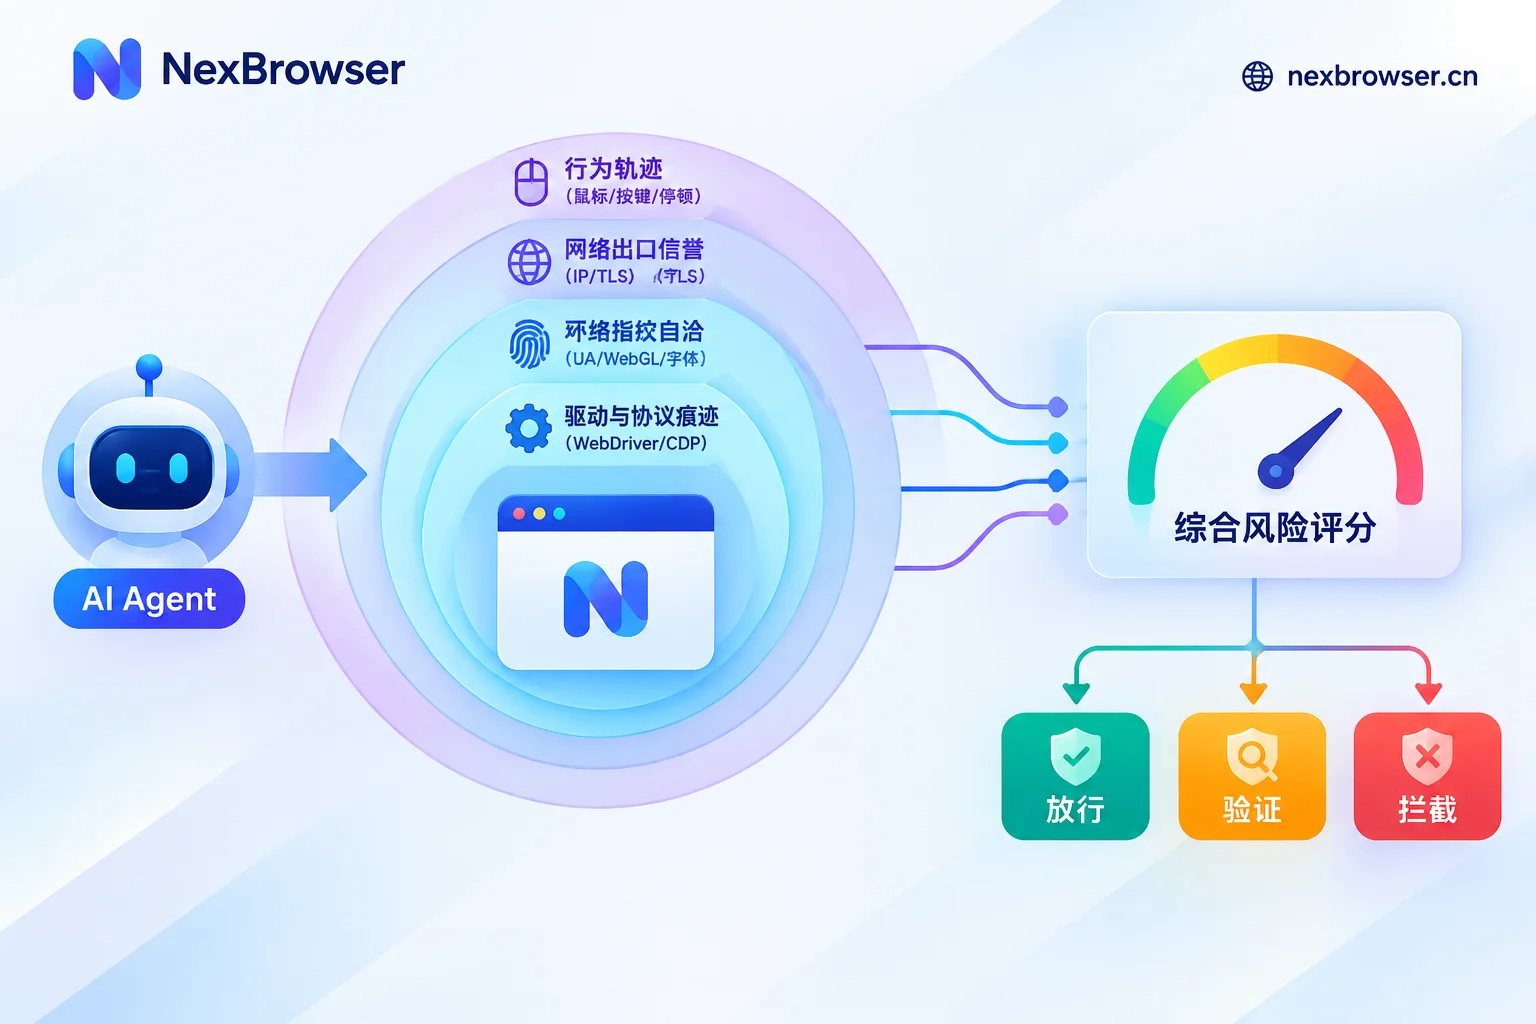
四层检测信号
1. 驱动和协议留下的痕迹
Playwright、Puppeteer、Selenium 这些常见框架,在默认设置下启动浏览器时会把 navigator.webdriver 设为 true。网页用一行脚本就能读到这个值。另外,CDP(Chrome DevTools Protocol)连接处于活跃状态,框架还会往页面运行时注入一些变量,这些都能被探测到。BrowserScan 这类检测页面就把 WebDriver 列为单独的检测项。
2. 无头浏览器的指纹前后矛盾
无头(Headless)模式下,User-Agent、客户端提示(Client Hints)、WebGL 渲染器、字体列表、插件这些值,往往和普通浏览器对不上。最典型的是 WebGL 渲染器显示为 SwiftShader 软件渲染,而不是一块物理显卡。
关键不在于某个值本身,而在于这些值之间互相矛盾。比如 UA 声称是 Windows 上的 Chrome,显卡却是软件渲染、字体也少了一大截,这种组合在真实用户里很少见。
3. 网络出口的信誉
IP 是初筛的主要依据。机房(数据中心)IP 在风控评分里本来就偏低,有第三方分析称,DataDome 的基础评分里 IP 声誉约占 25%–30%。自动化流量如果再走数据中心 IP,很容易直接被弹验证或被静默拦截。TLS 握手特征也归在网络层,同样会被拿来比对。
4. 操作行为
这一层近两年变化最大。Cloudflare Precursor、HUMAN Security 这类新一代防护会持续监测整段会话,而不只看某一次点击。真人操作鼠标时有手腕微动和轻微抖动,速度有快有慢,停顿后还会修正位置。脚本和 Agent 则常见匀速直线移动、固定的按键间隔,或者表单内容一瞬间整段填好。
AI Agent 为什么也会被识别
Agent 的「思考」在大模型里完成,但真正操作浏览器时,大多还是通过 CDP 或自动化 API。所以前三层的痕迹,它和普通脚本一样都有。到了行为层,Agent 按「读页面 → 推理 → 执行动作」的循环工作,节奏也有自己的规律,并不会天然像真人。
HUMAN Security 等安全机构的研究表明,现有的指纹探针加上连续的交互轨迹分析,已经能识别出 AI Agent 流量。防护厂商也把 AI Agent 当作专门的检测对象。识别出来之后是放行、限流还是拦截,由各网站自己决定。
对多账号运营者来说,能做什么
「保证不被识别」这个目标既做不到,也不该去追求。平台禁止的自动化,换什么工具都是违规的,结果怎样也没人能保证。真正能控制的是三件事:任务本身合规,环境不出低级破绽,出了问题能找到原因。
第一步:先确认这件事该不该自动化。 先查平台规则,看有没有官方 API 或卖家后台自带的批量工具,有就优先用。批量注册、刷评、抢购这类平台明确禁止的操作不要做。登录、支付、身份验证这些环节交给人工完成。
第二步:每个自有账号用一个独立环境,参数前后一致。 第 2 层说的就是这个问题:指纹自相矛盾比指纹「不够特殊」更容易引起注意。NexBrowser 按环境隔离,并让每个环境的指纹参数保持一致(UA、系统、显卡等相互对得上)。建好环境后,可以按新建浏览器环境后怎么确认隔离生效逐项核对出口、指纹和存储。如果要让 Agent 接管某个环境,可以参考AI Agent 怎么操作多账号浏览器。
第三步:每个环境绑定一个代理,并复测出口。 对应第 3 层。确认出口 IP 的类型、所在地区和环境的时区、语言一致,别让账号走机房 IP。NexBrowser 内置了 NexIP 住宅 IP 的一键配置,绑定和复测的方法见怎么给每个浏览器环境单独绑定代理并验证出口。
第四步:控制自动化的范围和频率。 自动化更适合重复、低风险的步骤,比如整理订单数据、查看消息、导出报表。频率保持在正常人工能完成的量级,关键操作前留一步人工复核。如果还在纠结用 Agent 还是固定流程,可以看浏览器 MCP 和 RPA 有什么区别。
被弹验证或受限时,按这个顺序排查
- 出口 IP:在环境里打开 IP 检测页,确认 IP 类型、地区,以及和环境时区是否一致。
- 自动化标记:在指纹检测页看 WebDriver 一项是否显示被检测到。
- 渲染与运行模式:检查 WebGL 渲染器是否显示为软件渲染,确认没有在无头模式下跑任务。
- 任务节奏:回看出问题前的操作频率,以及有没有密集的重复动作。
按这个顺序能排除大部分常见原因。如果四项都正常还是频繁受限,问题很可能出在平台对这类操作本身的规则上,这时应该回到第一步,重新评估这个任务适不适合自动化。


评论(0)